外观
价格与倍率
先看模型单价,再看分组倍率。 模型广场用于估价,使用日志用于核对每次实际扣费。
一个公式
对于按 token 计费、单价单位为「元 / 百万 tokens」的模型:
text
本次费用(元)≈ Σ(各项计费 tokens × 该项单价)÷ 1,000,000 × 分组倍率- 计费项目:普通输入、输出、缓存读取;部分模型还计缓存写入、音频输入等。
- 缓存:按模型对应的缓存单价计算,不能把同一段缓存内容同时按普通输入和缓存价重复计费。
- 分组倍率:在基础费用上乘一次。例如 0.22x 表示乘以 0.22,不是再打 0.22 折。
在哪看最终价格
打开模型广场,点进模型详情,确认计费方式、各项单价、分档条件和分组倍率。如果页面已经展示了分组折后价,不要再乘一次倍率。
长上下文分档计费
部分模型会按单次请求的输入长度切换价格档位。例如目前 Grok 文本模型以 200K 为分界,部分 GPT 模型以 272K 为分界;不是所有模型都使用同一个阈值。
以下为 2026-10-15 核对的 grok-4.6 基础价格,尚未乘分组倍率:
| 完整输入长度 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
| ≤ 200K | ¥2 / M | ¥6 / M | ¥0.5 / M |
| > 200K | ¥4 / M | ¥12 / M | ¥1 / M |
M = 1,000,000 tokens。 档位由请求长度决定,不是按整个月累计用量计算;当前价格以模型详情为准。
一个真实算例
下面是一笔历史使用日志:grok-4.6,Grok-Heavy 分组。
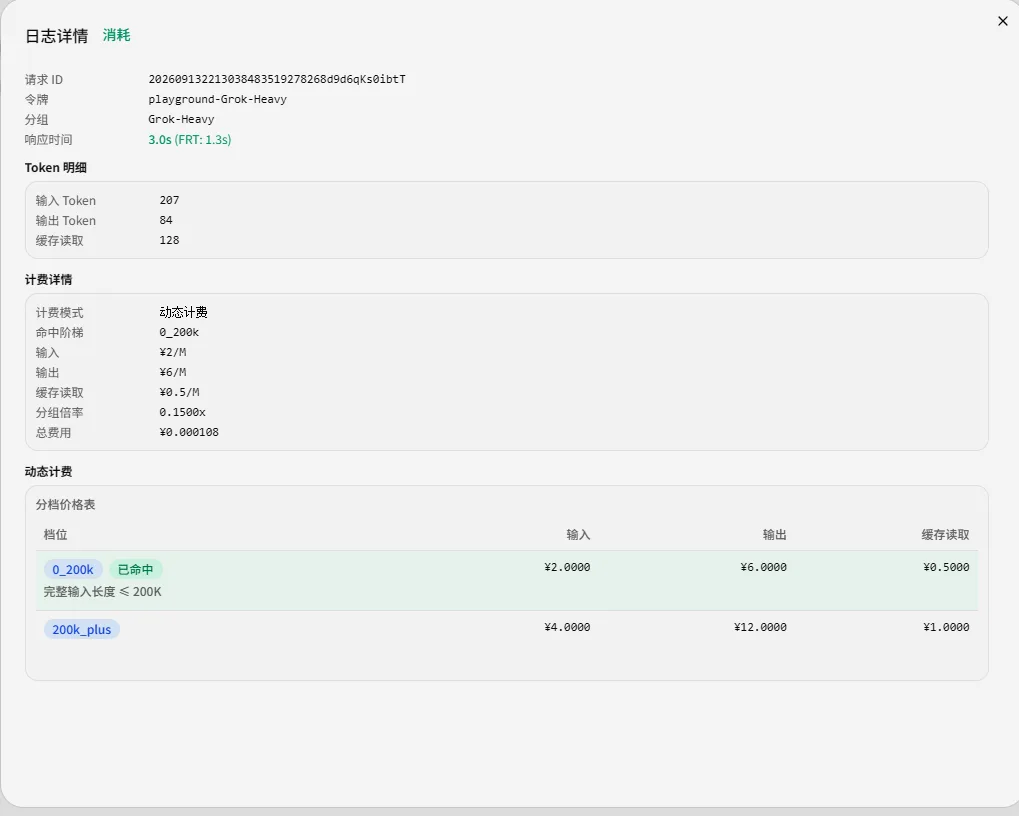
- 输入共 207 tokens,其中缓存读取 128 tokens;普通输入为
207 − 128 = 79。 - 输出 84 tokens,命中
0_200k档。 - 输入 ¥2/M、输出 ¥6/M、缓存读取 ¥0.5/M,分组倍率 0.15x。
text
(79 × 2 + 84 × 6 + 128 × 0.5) ÷ 1,000,000 × 0.15
≈ ¥0.000109
截图最终结算为 ¥0.000108。手算为近似估值,内部额度精度和显示位数会造成尾数差异,最终以日志结算为准。其他协议的输入统计口径可能不同,不要机械地套用「总输入减缓存」;先看该条日志的计费明细。
按次、绘图和视频怎么计费
- Gemini 按次:当前固定为 ¥0.03/次,使用
gemini-3.8-flash-按次;上下文仍受模型限制。 - 绘图 / 视频:可能按请求、张数、时长、分辨率等计费,不能套用上面的纯文本公式。
- 工具调用:模型支持工具协议,不代表所有上游工具都包含在基础价格里;请查看模型详情和日志。
自动重试可能产生新的请求。遇到超时或流式中断,先查日志再决定是否重发,尤其是长任务、绘图和视频任务。
余额显示与换算
控制台当前用人民币符号 ¥ 显示。面板 API 返回 quota 等内部额度值,不是直接显示的金额:
text
基础计价数值 = quota ÷ 500,000显示货币还受站点换算配置影响,不要把这个数值直接标成美元余额,也不要自行套用市场汇率。脚本需要金额时,见面板 API 的余额换算。
费用对不上时
先打开使用日志,核对模型 ID、密钥分组、输入 / 输出、缓存读写、价格档位和是否重试。联系站长时提供请求 ID、时间与脱敏截图,不要提供完整密钥。